

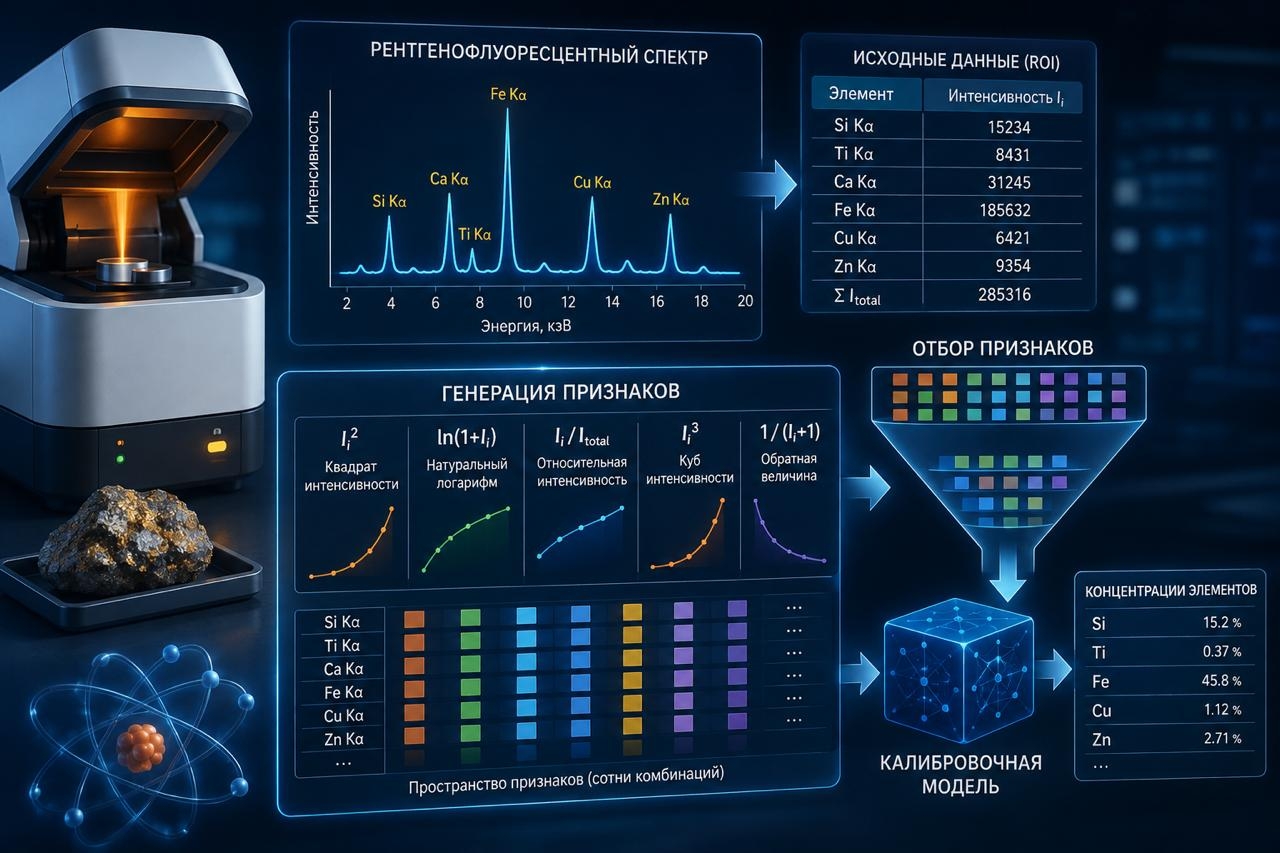
Генерация и отбор признаков в рентгенофлуоресцентном анализе
Почему интенсивности аналитической линии недостаточно
При анализе многокомпонентных материалов прямой переход от интенсивности аналитической линии Ii к концентрации элемента Сi затруднен несколькими физическими факторами.
Во-первых, на результат влияют матричные эффекты: характеристическое излучение определяемого элемента может поглощаться другими компонентами материала, одновременно возможно вторичное возбуждение. Во-вторых, изменение плотности и влажности руды или пульпы сказывается на интегральном рассеянии. Наконец, близко расположенные аналитические линии могут перекрываться. Например, Cu Kβ (8,905 кэВ) и Zn Kα (8,639 кэВ) разделены примерно на 0,27 кэВ, что сопоставимо с энергетическим разрешением SDD-детекторов.
В результате зависимость между интенсивностью и концентрацией становится нелинейной. Для учета взаимного влияния элементов в классическом РФА применяются, например, модели Лачанса–Трейла и Лукаса–Тута:
Ci = Ri · (1 + Σ αij · Cj) или Ci = a0 + Ii · (a1 + Σ bij · Ij) + Σ cij · (Ii / Ij)
Принципиальное различие заключается в том, что модель Лачанса–Трейла использует концентрации Cj мешающих элементов и решается итеративно, тогда как модель Лукаса–Тута строится на измеренных интенсивностях Ij.
При использовании машинного обучения этот подход можно расширить: передавать модели не только исходные интенсивности, но и их математические комбинации – отношения, суммы, разности и нелинейные преобразования. Так формируется пространство признаков, позволяющее модели учитывать сложные взаимосвязи между спектральными сигналами без ручного подбора каждой аналитической зависимости.
Генерация признаков
Исходными данными для алгоритма служат интенсивности Ii, измеренные в аналитических энергетических окнах элементов (ROI — Region of Interest), а также суммарная интенсивность спектра Itotal . Для каждой исходной интенсивности формируется несколько дополнительных признаков.
Квадрат интенсивности
f(Ii) = Ii2 – квадратичный (супралинейный, ускоряющийся) член задаёт общую кривизну зависимости и способен захватывать эффекты, при которых интенсивность растёт быстрее концентрации, например эффект вторичного возбуждения (флуоресцентного усиления) соседними элементами. Обратный по характеру эффект – самопоглощение – носит насыщающий (сублинейный) характер и корректнее описывается логарифмическим или обратным преобразованием (см. признак 2 и признак 4).
Натуральный логарифм
f(Ii) = ln(1 + Ii) – сжимает динамический диапазон признаков, стабилизирует дисперсию для примесных элементов с малым содержанием (Mo, Au, Ag) и компенсирует экспоненциальный закон затухания излучения Бугера-Ламберта-Бера.
Относительная интенсивность
f(Ii, Itotal) = Ii / (Itotal + 10-9) — критически важная физическая нормировка. Компенсирует флуктуации анодного тока рентгеновской трубки, изменение геометрии измерения и сухую массу пробы.
Куб интенсивности и обратная величина
f(Ii) = Ii3 — добавляет более высокий порядок кривизны для сильных супралинейных эффектов (например, при выраженном флуоресцентном усилении вблизи высоких концентраций основного элемента); значения этого признака могут достигать очень больших чисел, поэтому его обязательно нужно стандартизировать (см. Раздел 4, шаг 1). f(Ii) = 1 / (Ii + 1) — убывающая, насыщающаяся функция, которая, в отличие от куба, действительно отражает потери счёта из-за мёртвого времени детектора и наложения импульсов (pile-up) при высоких скоростях счёта.
Таким образом, одна исходная интенсивность превращается сразу в несколько вариантов математического представления сигнала. Но еще больше информации можно получить, если учитывать не отдельные линии, а взаимосвязи между интенсивностями разных элементов.
Межэлементные взаимодействия
Помимо преобразования отдельных интенсивностей, алгоритм формирует признаки для пар элементов (i) и (j). Они позволяют учитывать взаимное влияние компонентов исследуемого материала.
|
Тип признака |
Формула |
Физический смысл в РФА анализе |
|
Отношение |
Ii / (Ij + 10-9) |
Прямой аналог коэффициента матричного поглощения элемента j на линию элемента i (уравнения Lachance-Traill). |
|
Лог-отношение |
ln(1 + Ii / (Ij + 10-9)) |
Стабилизированное отношение для малых концентраций, сглаживающее выбросы при делении на малое значение. |
|
Сумма |
Ii + Ij |
Описывает суммарный вклад близких спектральных пиков и интегральный фон под наложенными линиями. |
|
Разность |
|Ii - Ij| |
Характеризует спектральный контраст между аналитической линией и соседней фоновой областью. |
|
Геометрическое среднее |
√(Ii · Ij) |
Моделирует мультипликативный эффект дополнительного (вторичного) флуоресцентного возбуждения — так называемый эффект усиления (enhancement effect). |
Размерность пространства признаков: При наличии N входных аналитических окон число сгенерированных признаков рассчитывается по формуле:
M = N (базовые) + 5N (одноэлементные) + 2N(N-1) (отношения) + 3 · [N(N-1)/2] (симметричные парные)
Например, при N = 10 элементах генерируется 10 + 50 + 180 + 135 = 375 признаков! Однако использовать все полученные комбинации нецелесообразно: многие из них избыточны, взаимно коррелируют или оказываются неустойчивыми. Поэтому после генерации массива возникает следующая задача — отобрать признаки, которые действительно несут полезную информацию для построения калибровочной модели.
Размножение данных пуассоновским шумом
Для построения калибровочной модели необходим набор опорных проб с известным химическим составом. На практике количество таких проб ограничено — обычно речь идет о 30–100 образцах. При большом количестве сгенерированных признаков небольшая обучающая выборка повышает риск переобучения модели.
Для увеличения объема тренировочных данных используется физически обоснованное размножение спектров — аугментация на основе статистики Пуассона: среднеквадратичное отклонение числа зарегистрированных импульсов N за время экспозиции t равно σ = √(N / t). На каждый базовый спектр накладывается случайный шум с соответствующей физической дисперсией:
Iаугм = max(0, Iбаз + N(0, σ2)), где σ = √(Iбаз / tэксп)
Таким образом, из одного исходного спектра можно получить несколько его статистически измененных вариантов. Обычно для каждого опорного спектра генерируется порядка 10 синтетических копий. При исходной выборке из 30–100 проб это позволяет существенно расширить тренировочный массив.
При достаточно большом количестве зарегистрированных импульсов пуассоновскую статистику можно приближенно описывать нормальным распределением. Для слабых сигналов более строгим подходом является непосредственное моделирование пуассоновского распределения.
После формирования расширенного набора данных можно переходить к следующему этапу – отбору наиболее информативных и устойчивых признаков из сотен полученных математических комбинаций.
Отбор наиболее информативных признаков
Сгенерированный массив содержит сотни признаков, многие из которых избыточны или сильно коррелируют между собой. Использование всех комбинаций может привести к неустойчивости калибровочной модели. Поэтому применяется двухстадийный алгоритм отбора признаков – Stability Selection.
На первом этапе все признаки приводятся к единому масштабу, после чего применяется LassoCV – линейная модель с L1-регуляризацией и кросс-валидацией. Алгоритм определяет оптимальную силу регуляризации (\alpha) и обнуляет коэффициенты наименее информативных признаков. Так выполняется первичная фильтрация большого массива.
На втором этапе проводится Bootstrap Stability Selection. Алгоритм многократно работает со случайными подвыборками, содержащими 85 % исходных данных. Для каждой такой подвыборки:
- выполняется отбор признаков с помощью Lasso;
- отобранные математические признаки объединяются с исходными физическими интенсивностями;
- обучается модель градиентного бустинга XGBoost;
- фиксируется важность каждого признака и частота его выбора.
После серии таких итераций признаки ранжируются по устойчивости. В итоговый набор попадают комбинации, которые регулярно оказываются информативными на разных подвыборках данных. В результате из нескольких сотен исходных комбинаций выбирается ограниченный набор Top-K – обычно от 10 до 35 признаков. Они приводятся к диапазону от 0 до 1 и передаются на следующий этап – обучение итогового ансамбля калибровочных моделей.
От спектра к калибровочной модели
Таким образом, генерация и отбор признаков позволяют перейти от простого сопоставления отдельных спектральных интенсивностей с концентрациями к работе с более сложными взаимосвязями, возникающими в многокомпонентных материалах.
При этом задача состоит не в том, чтобы сформировать как можно больше математических комбинаций. Важно найти среди них устойчивые признаки, которые сохраняют информативность на разных наборах данных и действительно помогают калибровочной модели учитывать нелинейные и межэлементные зависимости. Такой подход объединяет физическую природу рентгенофлуоресцентного анализа и возможности методов машинного обучения: исходной точкой остаются реальные спектральные сигналы, а математические алгоритмы помогают определить, какие взаимосвязи между ними наиболее значимы для расчета концентраций.
В следующих публикациях продолжим разбирать математические методы, которые используются при обработке данных РФА и построении калибровочных моделей.
ВАЖНО: При подготовке статьи использовались открытые научные публикации, техническая документация и другие профильные источники, мы не заявляем о научной новизне описанных методов и алгоритмов. Ссылки на основные материалы, использованные при подготовке публикации, приведены здесь – они позволят подробнее ознакомиться с описанными методами и их теоретическими основами.


2012-2026 © ООО "Техноаналитприбор"
ИНН 7705987050
КПП 770101001
ОГРН 1127746403421
Юридический адрес 105082, г. Москва, вн.тер.г. Муниципальный Округ Басманный, ул Бакунинская, д. 69, стр. 1, помещ. 13/6